Сетевой уровень — это основной уровень адресации и маршрутизации данных в сети.
В прошлой главе были рассмотрены способы коммутации пакетов и разделения трафика не выше интерфейсного уровня. В реальной сетевой практике также существуют решения, которые позволяют поверх интерфейсного уровня сразу реализовывать прикладной. Для таких случаев даже переопределяют термин «локальная сеть». Им обозначают не отдельные самостоятельные сети передачи данных, а именно сети без сетевого уровня стека протоколов.
Однако в такой реализации возникает множество собственных проблем. Ограничения по времени и качеству сигнала, унаследованные от физического уровня, отдельные протоколы для предотвращения зацикливаний, плохо масштабируемые механизмы избегания коллизий фреймов — лишь малая часть возможных трудностей.
Общие характеристики сетевого уровня
Сетевой уровень позволяет объединять среды передачи данных в глобальную сеть без привязки к реалиям нижележащих уровней.
Унификация на этом уровне достигается за счёт введения единой глобальной идентификации. Здесь определяются структура адреса и механизм раздачи адресов абонентам сети. В отличие от интерфейсного уровня, идентификаторы сетевого уровня не привязаны к конкретным устройствам. Это добавляет гибкость системе, например, даёт возможность трансляции адресов.
Систематизация на сетевом уровне заключается в обеспечении связности полученной сети. Здесь непосредственно возникает понятие маршрутизации. Глобальную сеть можно представить в виде графа, узлы которого — это абоненты сети (в том числе служебные, занимающиеся пересылкой пакетов), а рёбра — каналы передачи данных интерфейсного уровня. Тип этого графа, что неудивительно — «сеть». Каждое ребро сетевого графа имеет собственные настройки. Оно может отключиться, оказаться перегруженным данными и т.д. На сетевом уровне ведётся отслеживание связности сети, строится карта достижимости абонентов. Для крупных сетей строятся маршруты по умолчанию. WAT это предложение непонятно TODO вписать определение маршрутизации, хотя бы неформальное
Объёмы данных, описывающие все маршруты и абонентов, огромны и активно меняются во времени. Каждый час тысячи абонентов появляются и пропадают, постоянно изменяя топологию. В связи с этим что унификация, что систематизация в общем случае динамические.
IPv6
В рамках курса рассматривается протокол IPv6 стандарта rfc8200. Протокол был предложен в декабре 1995 года и тогда требовал масштабного изменения структуры сети. Поскольку осуществление настолько массовой перестройки было, мягко говоря, затруднительной задачей. Протокол не получил должного внимания в то время, несмотря на то, что решал множество проблем будущей (с нынешней точки зрения — современной) сетевой инфраструктуры.
Достаточно ясно и подробно про IPv6 представлено в докладе Jen “Furry” Linkova, мы постараемся в этой главе пройти по всем основным разделам доклада, описав все преимущества и особенности данного протокола
Структура адреса
Первое глобальное изменение в протоколе — новая структура IPv6-адреса. Очевидным недостатком IPv4 было малое количество адресов. Вместе с протоколом необходимо было изобретать и поддерживать механизм трансляции адресов, ограничивать диапазоны. IPv6 за счёт структуры в 128 бит вместо 32 позволяет в самом адресе описывать множество дополнительных параметров. Да и просто иметь многократно большее количество допустимых адресов.
Как и для IPv4, адреса IPv6 назначаются на интерфейсы. Назначение не уникальное — несколько адресов может быть установлено сразу на один интерфейс. Адреса записываются в формате гексетов (шестнадцатибитных блоков, обычно в формате двух 16-CC байтов), разделённых :. Поскольку адрес получается достаточно длинным, были введены стандарты сокращения адресов:
- незначимые нули гексетов могут опускаться;
- если в адресе есть несколько подряд идущих нулевых гексетов, они могут замещаться сокращением
::. Замещение может проводиться только один раз на самом большом диапазоне подряд идущих гексетов. Множественное сокращение невозможно.
Например, записи 2001:0db8:85a3:0000:0000:0370:008e:7334 и ` 2001:db8:85a3::370:8e:7334` описывают один и тот же адрес.
Маска сети также описывает разделение сети на части, однако в IPv6 работа с ними более строгая. IPv4-протокол, вообще говоря, не обязывал маску иметь единицы исключительно на первых битах адреса. Это могли быть любые биты, позиции которых фиксировали значения в адресе и определяли подсеть, которой принадлежит адрес. И исключительно из удобства расчётов, разделения сети на подсети и работы с адресами повсеместно используются маски с первыми единичными битами.
В протоколе IPv6 маска обязана задавать разделение на две части из последовательно идущих битов. И здесь для фиксации этого факта мы будем использовать новую терминологию. Первую часть адреса мы будем называть «префикс». Префиксы задают диапазоны адресов с одинаковыми N старшими битами. Очевидно, что длина префикса определяется количеством старших битов. Также очевидно, что длина префикса обратно пропорциональна количеству адресов в данном префиксе. Младшие биты будем называть «[интерфейсными] идентификаторами». Термин «подсети» по понятным соображениям покрывается термином «префикса», поскольку второй выступает идентификатором подсети, как некоторого множества адресов.
Категории и области действия адресов
Адреса можно разделить на несколько категорий:
- неопределённый адрес —
::, 128 нулей — может интерпретироваться в правилах маршрутизации, как любой адрес; - обычные адреса;
- специальные адреса (Это адреса с префиксом ff00::/8).
В большинстве литературы обычные адреса называют Unicast-адресами, специальные — Multicast-адресами. Это не совсем корректное название (в частности, для unicast), поскольку unicast и multicast — это типы доставки пакетов. Но поскольку тип доставки определяется форматом IP-адреса, мы будем называть адреса обоими вариантами (обычные/специальные и unicast/multicast).
Основное взаимодействие между абонентами происходит по обычным адресам. Говоря про них, можно выделить три области действия обычного адреса:
- loopback-адрес
::1(127 нулей и 1 единица) — используется для обращения внутри одной машины к себе самой. В отличие от IPv4, IPv6 loopback-адрес всего один; - link-local адреса (адреса с префиксом fe80::/10, то есть с первыми битами
1111 1110 10) — используются для работы строго в рамках одного сегмента сети. Особенности настройки и работы с такими адресами заслуживают подробного рассмотрения; - global unicast — обычные адреса, которые могут участвовать в глобальной маршрутизации.
LLA: внутриинтерфейсные адреса
Link-local адреса (далее LLA) — особый вид адресов с уникальным свойством: они принципиально немаршрутизируемы. Эти адреса уникальны и актуальны только в рамках одного сегмента сети. Они доступны напрямую в локальной среде: информация об узле с адресом из fe80::/10 в нашей таблице маршрутизации гарантирует нам, что этот абонент — прямой сосед.
Поскольку адреса уникальны только в рамках своего канала связи, без самого канала он не имеет смысла. Логично, ведь, в общем случае, машины на разных каналах с один и тем же адресом — это разные машины. Поэтому при работе с LLA адрес должен снабжаться пометкой об интерфейсе, на котором он находится. Например, fe80::3a%17 для обращения к абоненту на интерфейсе №17 с адресом fe80::3a; при этом fe80::3a%15 — вообще говоря, другой абонент.
Когда на устройстве активируется («поднимается») интерфейс, LLA генерируется автоматически, для этого существует специальный механизм SLAAC. По нему узел генерирует себе интерфейсный идентификатор (например, на базе MAC-адреса), после чего назначает себе адрес в префиксе fe80::/64 с младшими сгенерированными битами. Получается примерно такой адрес: fe80::1c80:9aa4:528e:bb85. Поскольку на заданном участке сети адрес должен быть уникальным, после его создания запускается процедура DAD — Duplicate Address Detection. DAD является частью отдельного протокола Neighbour Discovery (NDP), решающего задачу определения соседей. Работу протокола мы обсудим дальше, сейчас просто зафиксируем, что сгенерированный адрес проходит некоторую верификацию своей уникальности, при необходимости редактируется, после чего закрепляется.
LLA можно назначить и вручную, главное, сгенерировать его в префиксе fe80::/10. Например, использование 54 бит после префикса гарантирует несовпадение со всеми автогенерируемыми адресами WAT что кому что гарантирует? .
Используются link-local адреса, в основном, для служебных целей: для обнаружения соседей в локальной среде, для общения по динамическим протоколам (например, OSPF), для nexthop-ов маршрутов. Запрета для другого использования на них нет, поэтому для удобства можно пользоваться ими и для простого прикладного трафика.
Multicast: адреса групп узлов
В протоколе IPv6 особое внимание уделено Multicast-адресам. С их помощью возможно обеспечить взаимодействие между множеством абонентов, обладающих определёнными свойствами. Причём количество битов в IPv6-адресе позволяет задавать целые правила широковещания.
Мультикаст-группы также, как и юникаст, разделяются по областям действия адресов (по параметру scope):
| 1111 1111 xxxx xxxx rrrr rrrr .... ....   .............   gggg gggg gggg gggg gggg gggg gggg gggg |
| ^^^^ ^^^^      ^^^^ ^         ^                ^^         ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^ |
| multicast     scope reserved  prefixlen      64-bit                      group ID                 |
|           ^^^^                            network prefix                                          |
|           flags               <--- (if P-flag is 1) ---->                                         |
|                                                                                                   |
| [8 bits]  [4+4bits] [8 bits]  [8 bits]      [64 bits]                    [32 bits]                |
- scope = 1 (
ff01::/16) — interface-local; - scope = 2 (
ff02::/16) — link-local; - scope = 5 (
ff05::/16) — site-local; - scope = e (
ff0e::/16) — global;
Вот некоторые примеры адресов:
- ff02::1%eth1 — все узлы в локальной среде за eth1 (фактически это широковещание);
- ff02::2%eth1 — все маршрутизаторы в локальной среде за eth1;
- ff02::101%eth1 — все NTP-серверы в локальной среде за eth1;
- ff02::1:ff3a:d876%eth1 — все узлы в локальной среде за eth1, что имеют адрес, заканчивающийся на 24 бита
::3a:d876;
Доставка пакета
Параметры передачи пакетов в протоколе осуществляются на основе данных заголовка пакета. В нём есть ожидаемые поля с адресами получателя и отправителя, hop limit (для противодействия зацикливанию на сетевом уровне) и размер передаваемых данных, за которыми следует поле Next Header. В обычном случае там указывается тип заголовка транспортного уровня, однако в IPv6 существует поддержка расширенных заголовков (Extension headers), позволяющих задавать дополнительные параметры для обработки пакета на сетевом уровне.
Одним из расширенных заголовков решается задача фрагментации. Размер сегмента, приходящего с транспортного уровня, управляется логикой транспортного уровня и может быть больше, чем максимальный размер данных в IP-пакете. Сегменты, не укладывающиеся по размеру, предварительно фрагментируются и передаются независимыми IP-пакетами, после чего объединяются на конечном хосте получателя. При передаче такого трафика в каналах без гарантий передачи возникает множество проблем:
- При фрагментации заголовок транспортного уровня не дублируется. Сегмент просто разделяется на несколько частей без опознавательных знаков. При искажении заголовка сетевого уровня с информацией о сегментации восстановить порядок данных корректно не представляется возможным.
- Поскольку передача происходит независимо, каждый пакет с некоторой вероятностью может быть потерян, искажён и др. В итоге у получателя не будет возможности восстановить весь транспортный сегмент, а при повторной передаче передаваться будет снова всё множество пакетов. Таким образом кратно увеличивается нагрузка на сеть.
- Поскольку допустимый размер канала может быть разным на разных участках сети, уже сфрагментированные пакеты могут дополнительно фрагментироваться на ещё более мелкие части. TODO Мне не нравится эта выкладка. Первый пункт спорный, второй завуалированно толкует о TCP, третий — об IPv4.
Для уменьшения промежуточной фрагментации используется механизм фрагментации на стороне отправителя. При установке соединения между абонентами передаётся информация о значении самого «узкого» канала, и вся фрагментация сразу проводится под полученный размер. Для того, чтобы вообще избежать фрагментации, получаемое при соединении значение передаётся уровням выше в качестве рекомендации максимального размера пакетов. TODO Слово «соединение» явно намекает нам на то, что весь механизм реализован на транспортном уровне. Это так?
Для доставки пакета могут использоваться разные способы (собственно, типы доставки):
- unicast — пакет направляется одному получателю по адресу его назначения. На unicast строится простая передача данных между отдельными пользователями;
- anycast — пакет направляется по некоторому общему адресу группе получателей, принять его должен любой из них, например, ближайший. На такой схеме строится, например, обращение к распределённым серверам, которые дублируют друг друга. Отвечать будет тот, до которого лучше маршрут (менее нагруженный, более короткий и т.д.);
- multicast — пакет отправляется всем получателям в группе по некоторому адресу группы. На нём строится широковещательная рассылка и уже упоминаемые нами сервисные протоколы.
Благодаря расширенным заголовкам IPv6 без дополнительных протоколов можно задавать маршруты передачи пакетов. Для этого используется заголовок типа Routing. Самым актуальным подходом на сегодня является технология SRv6. В ней каждый маршрут представлен последовательностью сегментов, каждый из которых указывает на определённый сетевой узел или функцию. На отправляющем узле создаётся список сегментов, включающий узлы и функции, через которые должен пройти пакет. Эти сегменты добавляются в Routing-расширение заголовка и передаются в сеть. На каждом узле, поддерживающем SRv6, пакет извлекает текущий сегмент из расширения и выполняет действие, соответствующее этому сегменту. Если сегмент указывает на сетевую функцию (например, изменение заголовка или фильтрацию пакетов), она выполняется. Если сегмент указывает на следующий узел маршрута, пакет пересылается на этот узел.
В общем случае принятие решения о маршрутизации пакетов строится каждым абонентом независимо на базе его таблицы маршрутизации. При получении пакета производится поиск сети получателя в таблице. Для P2P-сред результатом поиска является интерфейс передачи, для многоабонентной среды — интерфейс и адрес следующего узла (конечного или промежуточного).
«Обычные» хосты в интернет либо порождают сетевой трафик в адрес других, либо принимают трафик, обращённый непосредственно к ним. Для того, чтобы пересылать пакеты, хост должен работать работать в режиме маршрутизатора — при этом меняются сразу несколько свойств работы его сетевого стека. Компьютер под управлением Linux может работать и в «обычном» режиме, и в режиме маршрутизатора, и произвольно включать / выключать свойства сетевого стека, выходя за рамки стандарта.
Заполнение маршрутных таблиц может быть организовано множеством способов. Очевидным является статическое заполнение маршрутов. Linux позволяет не просто задавать интерфейсы и next-hop адреса, но и описывать правила маршрутизации, инкапсулировать пакеты с дополнительными заголовками. Маршруты в таблицу могут добавляться автоматически при добавлении сети на интерфейсе. В IPv6 существует специальный протокол объявления сети от маршрутизатора (ICMP RD, его мы рассмотрим в будущих главах). Динамическая маршрутизация позволяет абонентам самостоятельно обмениваться доступными сетями и строить маршруты между узлами.
Специальные адреса и сети
Как и в IPv4, в IPv6 есть отдельно выделенные подсети, адреса в которых связаны со специальными типами трафика, протоколами, описанием и др. Актуальную таблицу таких сетей можно найти на сайте IANA. Кроме уже описанных нами из неё хочется выделить диапазон IPv4-mapped адресов (::ffff:0:0/96), отвечающих за кодировку IPv4-адресов для работы сокетов. TODO коротко на примере, что такое «кодировка для работы»
ICMP
Перед тем, как на практике рассмотреть работу протокола IPv6 и протокола Neighbour Discovery, рассмотрим протокол ICMP, с помощью которого узлы получают информацию о сетевых взаимодействиях.
ICMP — Internet Control Message Protocol — в его версии для IPv6 представляет не просто протокол информационных сообщений, а универсальный протокол общения между IPv6-абонентами. На его базе передаются данные о соседях в NDP, разрешается задача определения доступного MTU передаваемого фрейма (т.н. Path MTU Discovery).
Используемый нами в прошлой главе traceroute также построен на передаче ICMP-сообщений. От отправителя к получателю последовательно отправляются пакеты с увеличивающимся от 1 значением TTL (Time To Live). После каждой пересылки значение TTL в пакете уменьшается, по достижении нуля получателю возвращается ICMP-сообщение формата: “Ваше сообщение A не дошло до адресата B, закончился TTL на абоненте C”. Из такого списка адресантов ICMP-сообщений утилита строит «маршрут» передаваемых пакетов. В действительности, маршрутом это называть нельзя: передача каждого отдельного пакета происходит независимо, и, вообще говоря, пути их следования не обязаны быть одинаковыми. Поэтому результат traceroute следует трактовать не более как набор промежуточных узлов между отправителем и получателем с указанным расстоянием до отправителя.
Neighbour Discovery Protocol
Теперь разберём один из важнейших протоколов стека IPv6. Допустим, мы знаем IP адресата. Знаем, что он находится в локальной сети. Теперь нужно инкапсулировать пакет во фрейм, но для этого необходим MAC-адрес получателя, а он нам не известен.
Протокол NDP разработан в первую очередь для решения этой задачи. Также с его помощью можно определять, является ли соседний абонент маршрутизатором или конечным хостом (Router Discovery, о нем в следующей главе), и проверять допустимость собственного локального IP-адреса (DAD).
Протокол построен на принципе локального широковещания с запросом и ожидания ответа от конкретной группы абонентов. В случае с определением уникального адреса — «Есть ли кто-то с таким адресом в сети?». Для обнаружения маршрутизаторов — «Отвечают только маршрутизаторы: есть ли кто-то в сети?». Получая обратно ICMPv6-сообщения устройства самостоятельно строят таблицы связности с соседями, разбирают их по видам и др.
Для рассмотрения этого механизма на примере построим простую сеть их двух абонентов:
athena:
        eth1: intnet
router:
        eth1: intnet
Запустим на router отслеживание icmp6-трафика:
router
[root@router ~]# tcpdump -xx -n -v icmp6
tcpdump: listening on any, link-type LINUX_SLL2 (Linux cooked v2), snapshot length 262144 bytes
И поднимем на athena интерфейс в сторону router
athena
[root@athena ~]# ip link set eth1 up
[root@athena ~]#
При поднятии интерфейса на нём сгенерировался LLA. Для проверки уникальности этого адреса athena посылает в соответсвующий интерфейс сообщение, которое называется Neighbour Solicitation. Если быть более точным, это сообщение правильнее называть DAD-запрос:
18:19:02.431267 08:00:27:9a:a6:5e > 33:33:ff:9a:a6:5e, ethertype IPv6 (0x86dd), length 86: (hlim 255, next-header ICMPv6 (58) payload length: 32) :: > ff02::1:ff9a:a65e: [icmp6 sum ok] ICMP6, neighbor solicitation, length 32, who has fe80::a00:27ff:fe9a:a65e
          nonce option (14), length 8 (1): 4c 03 0c 40 93 ab
        0x0000:  3333 ff9a a65e 0800 279a a65e 86dd 6000  33...^..'..^..`.
        0x0010:  0000 0020 3aff 0000 0000 0000 0000 0000  ....:...........
        0x0020:  0000 0000 0000 ff02 0000 0000 0000 0000  ................
        0x0030:  0001 ff9a a65e 8700 043e 0000 0000 fe80  .....^...>......
        0x0040:  0000 0000 0000 0a00 27ff fe9a a65e 0e01  ........'....^..
        0x0050:  4c03 0c40 93ab                           L..@..
Запрос на поиск аналогичного адреса делается на широковещательный адрес ff02::1:ffMM:MMMM, где последние 24 бита совпадают с указанными в построенном адресе. Для MAC-адреса получателя также используется широковещание, Multicast Ethernet адрес на первые 24 бита MAC-адреса ставит специальное значение, последние 24 бита описывают сам MAC-адрес отправителя (поскольку если абонент с таким LLA существует, то он его получил таким же сгенерированным способом из собственного такого же MAC-адреса). Исходящий IP ставится ::, поскольку своего адреса на данный момент у абонента нет.
После отправки DAD-запроса абонент ожидает в течение таймаута (по умолчанию 1.5 секунды). Если за это время ему приходит ответ, значит такой LLA уже существует на данном сегменте сети. Полученный LLA перегенерируется и запрос отправляется снова уже на новый диапазон. Это продолжается до момента получения устойчивого уникального IPv6 LLA.
Поднимем на router интерфейс, на нём также сгенерируется LLA.
router
[root@router ~]# ip -br a
lo               UNKNOWN        127.0.0.1/8 ::1/128
eth0             DOWN
eth1             UP             fe80::a00:27ff:fec8:ae33/64
eth2             DOWN
eth3             DOWN
[root@router ~]#
Попробуем пустить трафик между абонентами, предварительно включив tcpdump на router:
athena
[root@athena ~]# ping -c2 fe80::a00:27ff:fec8:ae33%eth1
[root@athena ~]#
tcpdump поймает следующее:
router
18:24:35.388779 08:00:27:9a:a6:5e > 33:33:ff:c8:ae:33, ethertype IPv6 (0x86dd), length 86: (hlim 255, next-header ICMPv6 (58) payload length: 32) fe80::a00:27ff:fe9a:a65e > ff02::1:ffc8:ae33: [icmp6 sum ok] ICMP6, neighbor solicitation, length 32, who has fe80::a00:27ff:fec8:ae33
          source link-address option (1), length 8 (1): 08:00:27:9a:a6:5e
        0x0000:  3333 ffc8 ae33 0800 279a a65e 86dd 6000  33...3..'..^..`.
        0x0010:  0000 0020 3aff fe80 0000 0000 0000 0a00  .....:..........
        0x0020:  27ff fe9a a65e ff02 0000 0000 0000 0000  '....^..........
        0x0030:  0001 ffc8 ae33 8700 41b4 0000 0000 fe80  .....3..A.......
        0x0040:  0000 0000 0000 0a00 27ff fec8 ae33 0101  ........'....3..
        0x0050:  0800 279a a65e                           ..'..^
18:24:35.388827 08:00:27:c8:ae:33 > 08:00:27:9a:a6:5e, ethertype IPv6 (0x86dd), length 86: (hlim 255, next-header ICMPv6 (58) payload length: 32) fe80::a00:27ff:fec8:ae33 > fe80::a00:27ff:fe9a:a65e: [icmp6 sum ok] ICMP6, neighbor advertisement, length 32, tgt is fe80::a00:27ff:fec8:ae33, Flags [router, solicited, override]
          destination link-address option (2), length 8 (1): 08:00:27:c8:ae:33
        0x0000:  0800 279a a65e 0800 27c8 ae33 86dd 6000  ..'..^..'..3..`.
        0x0010:  0000 0020 3aff fe80 0000 0000 0000 0a00  ....:...........
        0x0020:  27ff fec8 ae33 fe80 0000 0000 0000 0a00  '....3..........
        0x0030:  27ff fe9a a65e 8800 2734 e000 0000 fe80  '....^..'4......
        0x0040:  0000 0000 0000 0a00 27ff fec8 ae33 0201  ........'....3..
        0x0050:  0800 27c8 ae33                           ..'..3
Запрос:
- оригинальное Neighbour Soсilitation также отправляется на Multicast Ethernet (байты 0x0000-0x0005) и Multicast IPv6 (0x0026-0x0035);
- этот фрейм содержит ICMPv6-пакет (байт 0x0014 равен
3a) типа NS (байт 0x0036 равен87) с запросом “Какой MAC у заданного IPv6?” (конкретный IPv6 в 0x003e-0x004d).
Ответ:
- ответ описывается в виде Neighbour Advertisement (байт 0x0036 равен
88) — объявлении об абоненте; - посылается уже на конкретный MAC-адрес и IPv6-адрес запрашивающего с конкретными параметрами своих идентификаторов.
В каждом из пришедших пакетов узел проверяет значение hop limit (оно должно оставаться 255).
По итогу у запрашивающего появится запись в таблице маршрутизации о link-local абоненте. Аналогичная запись появится и у ответчика, только другого статуса — STALE против REACHABLE у отправителя. Для того чтобы у получателя адрес отправителя был также «верифицирован и доступен для передачи трафика», он должен проделать процедуру ND со своей стороны самостоятельно.
После обмена информацией абоненты смогут передавать трафик:
router
18:24:35.389214 08:00:27:9a:a6:5e > 08:00:27:c8:ae:33, ethertype IPv6 (0x86dd), length 118: (flowlabel 0x03500, hlim 64, next-header ICMPv6 (58) payload length: 64) fe80::a00:27ff:fe9a:a65e > fe80::a00:27ff:fec8:ae33: [icmp6 sum ok] ICMP6, echo request, id 1, seq 1
        0x0000:  0800 27c8 ae33 0800 279a a65e 86dd 6000  ..'..3..'..^..`.
        0x0010:  3500 0040 3a40 fe80 0000 0000 0000 0a00  5..@:@..........
        0x0020:  27ff fe9a a65e fe80 0000 0000 0000 0a00  '....^..........
        0x0030:  27ff fec8 ae33 8000 d793 0001 0001 7326  '....3........s&
              :                 ^^             ^^^^
              :            type (echo)         seqn
        0x0040:  b669 0000 0000 0796 0500 0000 0000 1011  .i..............
        0x0050:  1213 1415 1617 1819 1a1b 1c1d 1e1f 2021  ...............!
        0x0060:  2223 2425 2627 2829 2a2b 2c2d 2e2f 3031  "#$%&'()*+,-./01
        0x0070:  3233 3435 3637                           234567
18:24:35.389245 08:00:27:c8:ae:33 > 08:00:27:9a:a6:5e, ethertype IPv6 (0x86dd), length 118: (flowlabel 0x4cb7a, hlim 64, next-header ICMPv6 (58) payload length: 64) fe80::a00:27ff:fec8:ae33 > fe80::a00:27ff:fe9a:a65e: [icmp6 sum ok] ICMP6, echo reply, id 1, seq 1
        0x0000:  0800 279a a65e 0800 27c8 ae33 86dd 6004  ..'..^..'..3..`.
        0x0010:  cb7a 0040 3a40 fe80 0000 0000 0000 0a00  .z.@:@..........
        0x0020:  27ff fec8 ae33 fe80 0000 0000 0000 0a00  '....3..........
        0x0030:  27ff fe9a a65e 8100 d693 0001 0001 7326  '....^........s&
              :                 ^^             ^^^^
              :            type (echo-reply)   seqn
        0x0040:  b669 0000 0000 0796 0500 0000 0000 1011  .i..............
        0x0050:  1213 1415 1617 1819 1a1b 1c1d 1e1f 2021  ...............!
        0x0060:  2223 2425 2627 2829 2a2b 2c2d 2e2f 3031  "#$%&'()*+,-./01
        0x0070:  3233 3435 3637                           234567
18:24:36.389426 08:00:27:9a:a6:5e > 08:00:27:c8:ae:33, ethertype IPv6 (0x86dd), length 118: (flowlabel 0x03500, hlim 64, next-header ICMPv6 (58) payload length: 64) fe80::a00:27ff:fe9a:a65e > fe80::a00:27ff:fec8:ae33: [icmp6 sum ok] ICMP6, echo request, id 1, seq 2
        0x0000:  0800 27c8 ae33 0800 279a a65e 86dd 6000  ..'..3..'..^..`.
        0x0010:  3500 0040 3a40 fe80 0000 0000 0000 0a00  5..@:@..........
        0x0020:  27ff fe9a a65e fe80 0000 0000 0000 0a00  '....^..........
        0x0030:  27ff fec8 ae33 8000 3891 0001 0002 7426  '....3..8.....t&
              :                 ^^             ^^^^
              :            type (echo)         seqn
        0x0040:  b669 0000 0000 a597 0500 0000 0000 1011  .i..............
        0x0050:  1213 1415 1617 1819 1a1b 1c1d 1e1f 2021  ...............!
        0x0060:  2223 2425 2627 2829 2a2b 2c2d 2e2f 3031  "#$%&'()*+,-./01
        0x0070:  3233 3435 3637                           234567
18:24:36.389474 08:00:27:c8:ae:33 > 08:00:27:9a:a6:5e, ethertype IPv6 (0x86dd), length 118: (flowlabel 0x4cb7a, hlim 64, next-header ICMPv6 (58) payload length: 64) fe80::a00:27ff:fec8:ae33 > fe80::a00:27ff:fe9a:a65e: [icmp6 sum ok] ICMP6, echo reply, id 1, seq 2
        0x0000:  0800 279a a65e 0800 27c8 ae33 86dd 6004  ..'..^..'..3..`.
        0x0010:  cb7a 0040 3a40 fe80 0000 0000 0000 0a00  .z.@:@..........
        0x0020:  27ff fec8 ae33 fe80 0000 0000 0000 0a00  '....3..........
        0x0030:  27ff fe9a a65e 8100 3791 0001 0002 7426  '....^..7.....t&
              :                 ^^             ^^^^
              :            type (echo-reply)   seqn
        0x0040:  b669 0000 0000 a597 0500 0000 0000 1011  .i..............
        0x0050:  1213 1415 1617 1819 1a1b 1c1d 1e1f 2021  ...............!
        0x0060:  2223 2425 2627 2829 2a2b 2c2d 2e2f 3031  "#$%&'()*+,-./01
        0x0070:  3233 3435 3637                           234567
Табличная маршрутизация
Для соседних абонентов и LLA схема обмена и настройки понятна. Теперь переходим непосредственно к маршрутизации.
srv:
        eth1: intnet
router:
        eth1: intnet
        eth2: deepnet
client:
        eth1: deepnet
По умолчанию используется destination-based маршрутизация: маршрут определяется по адресу получателя, вернее, по префиксу сети, к которой он принадлежит.
Длина префикса часто записывается в виде числа после символа слеша (/48), реже — как последовательность 1 в двоичном виде.
# sipcalc 2001:db8:ab::3:4:56a/64
-[ipv6 : 2001:db8:ab::3:4:56a/64] - 0

[IPV6 INFO]
Expanded Address        - 2001:0db8:00ab:0000:0000:0003:0004:056a
Compressed address      - 2001:db8:ab::3:4:56a
Subnet prefix (masked)  - 2001:db8:ab:0:0:0:0:0/64
Address ID (masked)     - 0:0:0:0:0:3:4:56a/64
Prefix address          - ffff:ffff:ffff:ffff:0:0:0:0
Prefix length           - 64
Address type            - Aggregatable Global Unicast Addresses
Network range           - 2001:0db8:00ab:0000:0000:0000:0000:0000 -
                          2001:0db8:00ab:0000:ffff:ffff:ffff:ffff
В спецификации протокола IPv6 описана теоретическая модель работы узла. В ней на интерфейс назначается префикс с длиной, и из этого префикса узел берёт себе ноль или более адресов. Linux на эту модель не опирается. Он даёт возможность назначить на сетевом интерфейсе адрес с длиной префикса.
При ручной настройке IP+префикса на сетевом интерфейсе Linux по умолчанию вносит в таблицу маршрутизации запись вида: «такая-то IP-подсеть находится непосредственно за этим сетевым интерфейсом», предполагая, что адреса в этом префиксе доступны напрямую по локальной среде.
srv
[root@srv ~]# ip link set dev eth1 up
[root@srv ~]# ip addr add dev eth1 2001:db8:0:a::56a/64
[root@srv ~]# ip -6 r
2001:db8:0:a::/64 dev eth1 proto kernel metric 256 pref medium
[root@srv ~]# ping 2001:db8:0:a::56b
PING 2001:db8:0:a::56b (2001:db8:0:a::56b) 56 data bytes
^C
1 packets transmitted, 0 received, 100% packet loss, time 0ms
[root@srv ~]# ip -6 n
2001:db8:0:a::56b dev eth1 INCOMPLETE
[root@srv ~]# ping 2001:db8:0:b::400
ping: connect: Network is unreachable
Неявное правило из таблицы маршрутизации гласит, что с абонентом мы связаны единой средой передачи данных, и сетевая подсистема вправе ожидать появления MAC-адреса этого 2001:db8:0:a::56b в таблице соседей, построенной по NDP.
Адрес 2001:db8:0:b::400 в подсеть не входит. Других записей в таблице маршрутизации у нас нет — как следствие, сообщение о недостижимости.
Попробуем на router явно задать нужный префикс, не задавая в нём адрес. Его наличие в таблице маршрутизации обеспечивает связь с абонентами из этой сети. Ответные сообщения будут без проблем доходить по LLA и, соответственно, сети fe80::/64, потому что она просто доступна (и информация о ней есть всегда, потому что LLA есть у всех, и такие подсети на сегментах есть всегда).
router
[root@router ~]# ip link set dev eth1 up
[root@router ~]# ip addr add dev eth1 fe80::2/64
[root@router ~]# ping -c 1 2001:db8:0:a::56a
ping: connect: Network is unreachable
[root@router ~]# ip r add 2001:db8:0:a::/64 dev eth1
[root@router ~]# ping -c 1 2001:db8:0:a::56a
PING 2001:db8:0:a::56a(2001:db8:0:a::56a) 56 data bytes
64 bytes from 2001:db8:0:a::56a: icmp_seq=1 ttl=64 time=1.84 ms
[root@router ~]#
При наличии нескольких адресов на одном узле (даже на разных интерфейсах) необходимо дополнительно решать задачу выбора адреса отправителя. Для этого используется специальный протокол Source Address Selection. Работает он просто: попарное сравнение адресов с поиском максимального по нескольким критериям. Сравнение идёт последовательно от самого важного критерия к наименее значимому.
- наименьший scope, но не меньше, чем у D (Link-Local < Global);
- адрес с preferred lifetime > 0 круче, чем с истекшим;
- адрес, назначенный на интерфейсе, за которым next-hop, круче, чем адрес на другом интерфейсе;
- временный адрес круче не-временного;
- из двух адресов круче тот, чей префикс имеет больше общих старших битов c D.
Теперь настроим связь с client. Для начала зададим второй адрес на маршрутизаторе. Поскольку LLA уникальны только в пределах среды за интерфейсом, мы можем взять такой же — fe80::2/64.
router
[root@router ~]# ip link set dev eth2 up
[root@router ~]# ip addr add dev eth2 fe80::2/64
[root@router ~]#
Теперь добавим адрес из другой глобальной сети на client. Здесь нам уже принципиальны именно глобальные адреса, поскольку необходимо будет их маршрутизировать. Также нужно добавить само правило маршрутизации. На client будем использовать маршрутизацию по умолчанию — в правило вместо конкретной подсети получателя пишется ключевое слово default. Оно обозначает сеть с нулевой сетевой маской ::/0 — т. е. весь Интернет. Такой записи соответствует вообще любой пакет.
client
[root@client ~]# ip link set dev eth1 up
[root@client ~]# ip addr add dev eth1 2001:db8:0:b::400/64
[root@client ~]# ping -c1 fe80::2%eth1
PING fe80::2%eth1(fe80::2%eth1) 56 data bytes.
64 bytes from fe80::2%eth1: icmp_seq=1 ttl=64 time=0.864 ms
[root@client ~]# ping 2001:db8:0:a::56a
ping: connect: Network is unreachable
[root@client ~]# ip -6 route add default via fe80::2 dev eth1
[root@client ~]# ip -6 r
default via fe80::2 dev eth1
fe80::/64 dev eth1 proto kernel metric 256 pref medium
На srv также настраиваем маршрут, только уже на конкретный префикс:
srv
[root@srv ~]# ip -6 route add 2001:db8:0:b::/64 via fe80::2 dev eth1
[root@srv ~]# ip -6 r
2001:db8:0:a::/64 dev eth1 proto kernel metric 256 pref medium
2001:db8:0:b::/64 via fe80::2 dev eth1 metric 1024 pref medium
fe80::/64 dev eth1 proto kernel metric 256 pref medium
[root@srv ~]#
Вторая запись в таблице означает: нам известно, что для посылки пакетов в сеть 2001:db8:0:b::/64 их надо направлять на интерфейс eth1 к fe80::2 (это маршрутизатор, он разберётся).
Адрес получателя уже не считается недостижимым, ping-запрос уходит, однако ответа от client нет.
Дело в том, что изначальная настройка Linux-машины не предполагает маршрутизацию между интерфейсами — работа ведется в режиме конечного абонента. Необходимо либо сделать на интерфейсном уровне мост, либо на сетевом уровне разрешить пересылку пакетов между интерфейсами, IP forwarding, что является частью работы в режиме маршрутизатора.
TODO Здесь и далее заменить «пробрасывание» на «пересылку»
Для включения маршрутизации между интерфейсами необходимо изменить параметры настройки пробрасывания пакетов WAT три родительных падежа . Пробрасывание пакетов можно установить на конкретном интерфейсе, тогда приходящие на него пакеты будут пробрасываться, а другие - нет. Также можно установить пробрасывание на все интерфейсы сразу. Для настройки всех интерфейсов можно использовать специальный конфигурационный файл. Также можно воспользоваться утилитой sysctl, с помощью которой доступна настройка как всех, так и отдельных интерфейсов.
TODO Ещё раз уточнить, какой sysctl включает именно режим маршрутизатора (он же выключает приём ICMP RA и ещё там что-то)
router
[root@router ~]# cat /proc/sys/net/ipv6/ip_forward
0
[root@router ~]# sysctl net.ipv6.conf.eth1.forwarding
net.ipv6.conf.eth1.forwarding = 0
[root@router ~]# sysctl net.ipv6.conf.eth2.forwarding
net.ipv6.conf.eth2.forwarding = 0

[root@router ~]# sysctl net.ipv6.conf.eth1.forwarding=1

[root@router ~]# cat /proc/sys/net/ipv6/ip_forward
0
[root@router ~]# sysctl net.ipv6.conf.eth1.forwarding
net.ipv6.conf.eth1.forwarding = 1
[root@router ~]# sysctl net.ipv6.conf.eth2.forwarding
net.ipv6.conf.eth2.forwarding = 0

[root@router ~]# sysctl net.ipv6.conf.all.forwarding=1

[root@router ~]# cat /proc/sys/net/ipv6/ip_forward
1
[root@router ~]# sysctl net.ipv6.conf.eth1.forwarding
net.ipv6.conf.eth1.forwarding = 1
[root@router ~]# sysctl net.ipv6.conf.eth2.forwarding
net.ipv6.conf.eth2.forwarding = 1
[root@router ~]#
Мы будем управлять исключительно параметром для всех интерфейсов сразу.
router
[root@router ~]# sysctl net.ipv6.conf.all.forwarding=1
Все упомянутые параметры тонко взаимодействуют друг с другом и неявно переключают друг друга неочевидным образом; останавливаться на этом в главе подробно не представляется возможным. TODO Довольно мутное утверждение, лучше вместо него сказать что-то более определённое, см. выше
По итогу всех действий получается простая рабочая табличная маршрутизация:
- Получаем пакет
- Просматриваем все записи в таблице, из них выбираем те, в префиксе которых лежит адрес получателя пакета (применяем к нему соответствующую маску и сравниваем префикс маршрута с результатом)
- Если настроен маршрут по умолчанию (с сетевой маской длины 0), он всегда подходит
- Среди подходящих записей выбирается та, что имеет самый длинный префикс (т. е. в которой меньше абонентов)
- Если это запись вида «сеть dev интерфейс», обращаемся за адресом к ND-таблице соседей, если «сеть via адрес» — используем этот адрес
- Пересылаем пакет на найденный адрес
Домашнее задание
- Суть: объединить четыре компьютера тремя сетями по простой линейной схеме:
clone←сеть3→subrouter←сеть2→router←сеть1→base
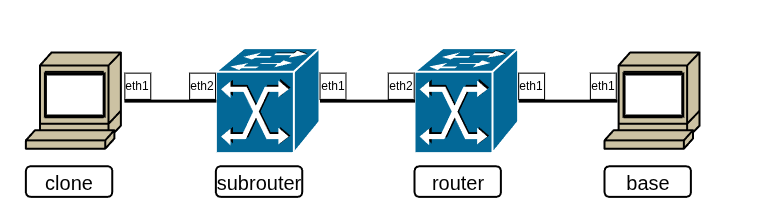
- На машинах
cloneиbase— по одному интерфейсу - На машинах
subrouterиrouter— два, там настроить маршрутизацию - Обеспечить доступность между
cloneиbase
- Отчёт (выполнятся с нуля на ненастроенных машинах):
report 4 clone- Настройка/поднятие интерфейса
- Дополнительные настройки маршрутизации (если нужны)
tcpdump -c4 -i интерфейс udp(должен показать пинги)traceroute -q4 -m3 адрес_base(должен проходить)
report 4 subrouter- Настройка/поднятие двух интерфейсов
- Дополнительные настройки маршрутизации (если нужны)
report 4 router- Настройка/поднятие двух интерфейсов
- Дополнительные настройки маршрутизации (если нужны)
report 4 base(выполняется последним)- Настройка/поднятие интерфейса
- Дополнительные настройки маршрутизации (если нужны)
traceroute -q4 -m3 адрес_clone(должен проходить)tcpdump -c4 -i интерфейс udp(должен показать пинги с машины clone) TODO Не добавить ли короткий traceroute, который не должен пройти?
- Четыре отчёта (
report.04.base,report.04.subrouter,report.04.routerиreport.04.clone) именно с такими названиями переслать одним письмом в качестве приложений на uneexlectures@cs.msu.ru- В теме письма должно встречаться слово
LinuxNetwork2027
- В теме письма должно встречаться слово